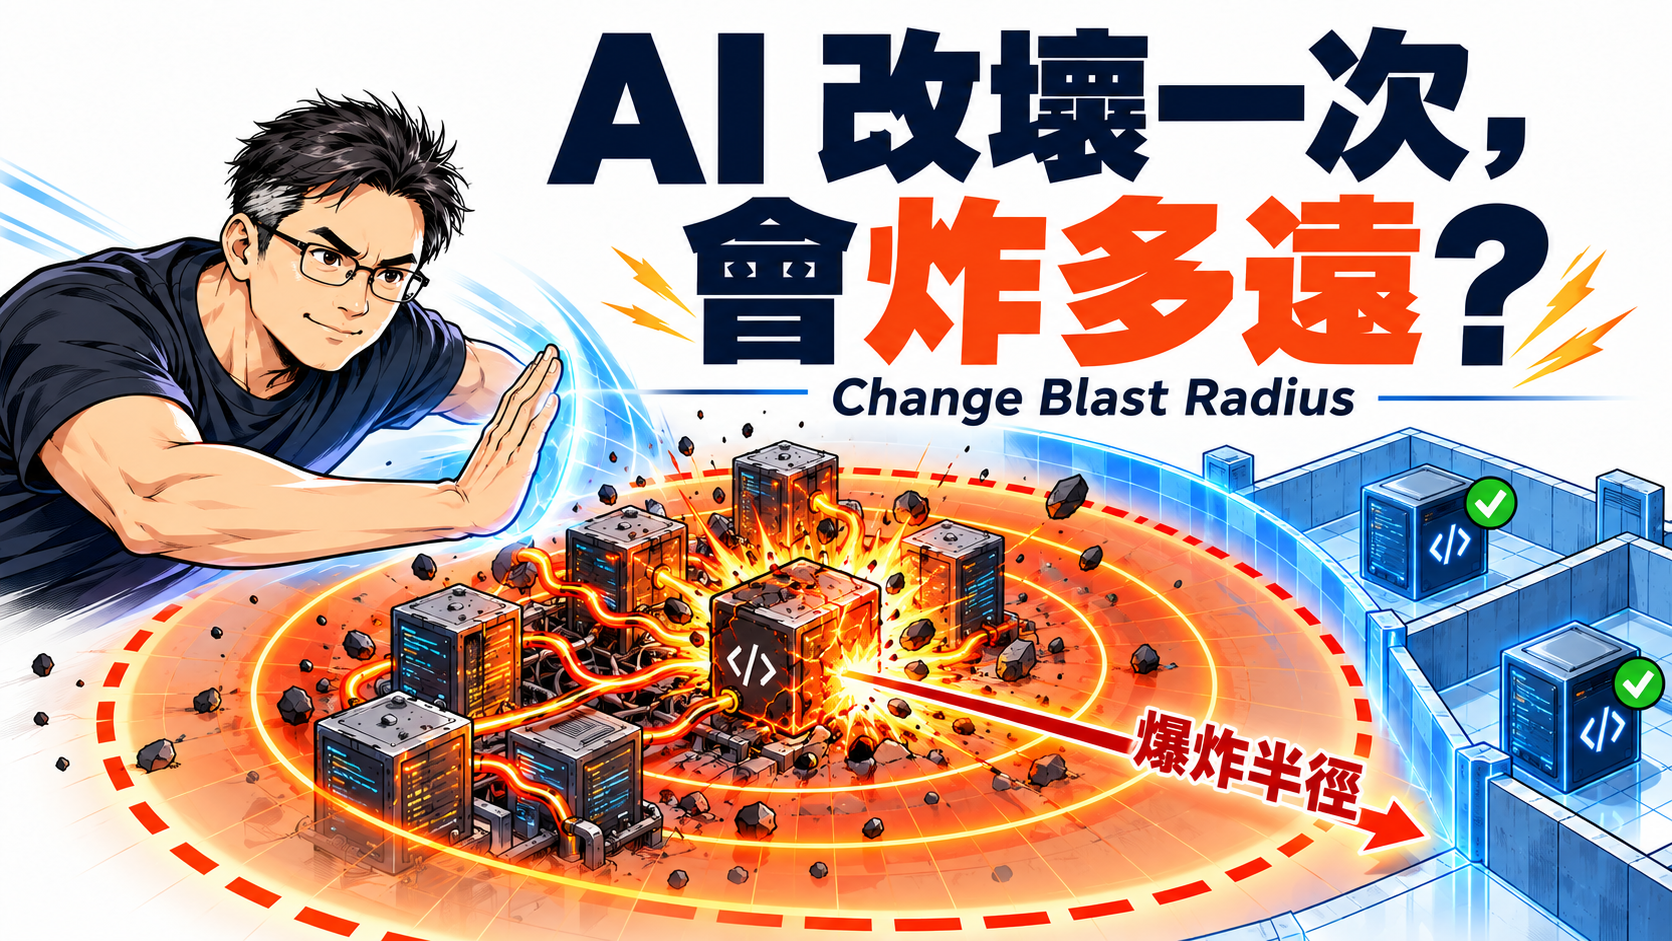
什麼是爆炸半徑(Blast Radius)?
這個詞原本不是軟體工程的專有名詞。
但意義很簡單,就是一個東西爆炸之後,影響範圍會有多大。
把這個概念放到資安裡面,就變得非常有意思。
假設今天一組帳號密碼被偷了,攻擊者登入之後,只能碰到某一個系統、某一小部分資料,這個 Blast Radius 就很小。
反過來說,如果這個帳號剛好有很大的權限,可以從一台機器一路橫向移動到其他系統,最後碰到 Database、Storage、其他帳號,甚至整個企業環境,那爆炸半徑就很大。
所以現在資安一直在談 Zero Trust,其中一個很重要的精神就是 Assume Breach。
不要假設「一定不會被攻破」。
而是反過來假設:倘若總有一天可能會被攻破,那我要怎麼讓事情發生之後,不要一路炸出去?
這也是為什麼會有 Least Privilege、Network Segmentation、Micro-segmentation 這些做法。
把網路、Workload、權限切開,每一區只允許真正必要的存取。某一區出問題,就盡可能把影響限制在這一區,不要讓攻擊者很容易 lateral movement,一路橫向移動。
Microsoft 在 Zero Trust 的文件裡,對 Assume Breach 的描述其實就直接寫得很清楚:Minimize blast radius and segment access。
所以 Micro-segmentation 的目的,不只是把網路切得很漂亮。
真正的目的是,控制爆炸半徑。
那軟體開發有沒有爆炸半徑?
其實也有。
只是爆炸的東西不一定是資安攻擊,我這邊想談的是「一次 Change」。
今天有人改了五行 Code,看起來很小。
但如果這五行剛好改到 Authentication Middleware、共用 Library、共用 DTO、Database Schema,最後可能影響十幾個 Project、好幾個 Service,甚至整套系統。
所以:
Diff 很小,不代表 Change 很小。
真正該問的是:
這一次修改如果錯了,最遠會影響到哪裡?
這就是我現在很在意的一個概念:Change Blast Radius。
其實這也不是什麼全新的理論。
Google 在談可靠性設計時,一直都有 Failure Domain、Compartmentalization、Canary、Staged Rollout 這些概念。核心都是同一件事情:不要期待永遠不出錯,而是想辦法讓錯誤發生之後,只影響有限的範圍。
AWS 的 Well-Architected Framework 也一直在談 Fault Isolation、Bulkhead、Cell-based Architecture,道理都差不多。
好的架構,不只是降低出錯的機率。
還要限制出錯之後,能炸多遠。
一件以前講過的事情
我先前在 DevOpsDays Taipei 的分享裡,曾經提過一個觀點:
AI 開發的時代,Repository 應該要開始縮小。
當時我是從 Context Window 的角度去談這件事情。
AI 不管再怎麼強,都不代表你應該把整個企業系統、幾百萬行 Code,一股腦全部丟給它。
Context Window 當然一直在變大,但「放得進去」和「真的能有效理解」是兩件不同的事情。長上下文相關研究其實早就發現,當 Context 變得很長,模型對資訊的利用並不一定穩定。
所以真正比較好的做法,不是一直追求更大的 Context Window。
而是讓 AI 每一次只需要理解它真正該理解的範圍。
這也是為什麼我一直覺得,「高內聚、低耦合」,在 AI 時代反而比以前更重要。
Repository 如果夠小,邊界夠清楚,AI 在做自動化開發的時候,需要搜尋的 Code 比較少、需要理解的 Dependency 比較少、需要推論的範圍也比較小。
當然,Repository 小不代表 AI 就一定會寫對。
但至少我們是在幫它把問題縮小,而不是每一次都叫它面對整座森林。
還有另外一個更重要的理由
其實,我(DevOpsDays)當天沒(時間)講的是,縮小 Repository ,還有另外一個更重要的理由
就是控制 Change Blast Radius。
假設今天有一個很大的 Monorepo,裡面什麼雜七雜八的東西都有:
Customer
Order
Payment
Inventory
Notification
Report
Authentication
Shared Library
Shared Database
現在 AI Agent 接到一個任務:
幫我修改 Order 的折扣計算。
一開始它可能只改 Order。
接著發現共用 DTO 不夠,去改 DTO。
然後發現某個 Shared Library 的 Interface 不符合,又改 Shared Library。
接著 Consumer 壞掉,再一路去改 Payment、Report,最後連 Test、Pipeline 都一起動。
原本只是一個小功能,最後變成二十幾個檔案、好幾個 Project 一起修改。
這就是 AI 開發時很實際的 Change Blast Radius。
反過來,如果我們本來就把系統設計成幾個高內聚、低耦合的 Bounded Context,每一個 Service 有清楚的 API Contract、自己的資料責任、自己的 Test、自己的 Deployment Boundary,甚至對應自己的 Repository,那 AI 的修改就比較容易被鎖在一個相對較小的範圍內。
今天要改 Order,就盡量只在 Order 裡面完成。
Payment 不要碰。
Member 不要碰。
Inventory 不要碰。
如果真的需要跨服務,那就透過明確的 Contract 去處理,而不是讓彼此的內部實作糾纏在一起。
這個時候 Repository 就不只是 Source Code 放在哪裡而已。
它其實開始變成一個 Change Containment Boundary。
重新看待微服務
過去我們談 Microservices,常常談的是 Scalability、Independent Deployment、Team Autonomy。
這些都沒有錯,而且到今天依然很重要。
但是在 AI 開始真正進入開發流程,甚至 AI Agent 可以自己讀 Code、改 Code、跑 Test、送 Pull Request 之後,你會發現一件事情:
Microservices 另外一個很重要的價值,是它比較有機會幫我們控制 AI 的 Change Blast Radius。
Microsoft 的 Microservices Architecture Guide 本身就提到,Microservices 的 Small Code Base、Fault Isolation、Data Isolation,可以降低不同元件之間的依賴,讓一個 Service 的變更比較不容易一路影響其他部分。
這跟資安裡的 Micro-segmentation,其實有一個很有趣的對稱。
資安在做的是:
把系統切開,避免攻擊橫向擴散。
軟體架構在做的是:
把系統切開,避免 Change 和 Failure 橫向擴散。
一邊控制的是攻擊的 Blast Radius。
另外一邊控制的是 Change 的 Blast Radius。
但這裡有一個很重要的前提
把一個 Repository 拆成十個,不代表爆炸半徑就會變小。
舉個例子,假設我們把訂單、付款、庫存,分別放到三個 Repository。
看起來已經拆開了。
但修改訂單功能時,如果還是得去改付款的程式、動庫存的資料表,最後三個系統還要一起部署,那其實它們仍然綁在一起。只是程式碼放在不同地方而已。
一個地方改錯,還是可能全部受到影響。
所以我們說的「邊界」,意思其實很簡單:
改訂單的功能,能不能盡量在訂單系統裡面完成?
訂單相關的規則(注意這個字,這是我提出RDD的基礎)、程式碼、測試,以及它負責管理的資料,盡量放在同一個清楚的範圍內。修改之後,也能單獨測試、單獨部署,不需要拉著付款和庫存一起改。
如果需要跟其他系統合作,就透過約定好的 API 或事件交換資訊。例如訂單成立後,透過事件機制(例如 event/service bus)通知庫存系統扣庫存,而不是由訂單系統直接去修改庫存的資料表。
這樣一來,AI 要修改訂單的折扣計算,就比較有機會只處理訂單這一塊,不必一路改到付款、庫存,甚至整套系統。
當然,不是每個功能都能完全獨立,跨系統的修改還是會有。但我們可以讓這種牽連更少一點。
相關的東西放在一起,不相關的東西不要綁得太緊。
這就是這裡想講的高內聚、低耦合,也是縮小 Repository 時真正該注意的事。
AI 時代,微服務的理由正在改變
我不能說,因為有 AI,所以所有系統都應該改成 Microservices。
那會太極端。
一個設計得好的 Modular Monolith,一樣可以有很清楚的模組邊界,也一樣可以把 Change 控制在很小的範圍。
但是如果一個大型系統本來就有足夠的複雜度,需要往服務化發展,那我現在會多考慮一個以前沒有被考慮過的原因:
這個架構,能不能讓 AI 每一次只修改它該修改的那一小塊?
以前我們設計架構,常常在想:
- 怎麼 Scale?
- 怎麼部署?
- 怎麼讓 Team 可以獨立開發?
- 怎麼提高 Availability?
現在還要再多一題:
如果明天大量的 Code 都是 AI Agent 在修改,我要怎麼控制每一次 Change 的爆炸半徑?
我覺得這會慢慢變成 AI 時代很重要的一個 Architecture Quality Attribute。
最後,我覺得可以借用 Zero Trust 的精神。
資安是 Assume Breach。
軟體開發也許應該開始有一點 Assume Bad Change 的想法。
不是不相信 AI。
人類寫 Code 一樣會寫錯(而且搞不好更容易錯)。
但真正成熟的工程設計,本來就不該建立在「每一次 Change 都一定正確」這個假設上。
所以 AI 時代好的架構,不是讓 AI 有能力一次理解、修改整個系統。
剛好相反。
好的架構,是讓 AI 根本不需要理解整個系統,也能安全地完成一次 Change。
而我認為,這可能才是 AI 時代我們重新思考 Repository 大小、邊界與模組化,甚至 Microservices 和架構設計最值得關注的理由。
參考資料
- Microsoft Learn, Apply Zero Trust principles to segmenting Azure-based network communication
https://learn.microsoft.com/en-us/security/zero-trust/azure-networking-segmentation - Microsoft Learn, Zero Trust security in Azure
https://learn.microsoft.com/en-us/azure/security/fundamentals/zero-trust - Google, Building Secure and Reliable Systems – Chapter 8: Design for Resilience
https://google.github.io/building-secure-and-reliable-systems/raw/ch08.html - Google, Building Secure and Reliable Systems – Chapter 21(Canary / Staged Rollout 與 Blast Radius)
https://google.github.io/building-secure-and-reliable-systems/raw/ch21.html - AWS Well-Architected Framework, Fault Isolation / Bulkhead Architecture
https://docs.aws.amazon.com/wellarchitected/latest/framework/rel-10.html - Microsoft Azure Architecture Center, Microservices Architecture Style
https://learn.microsoft.com/en-us/azure/architecture/guide/architecture-styles/microservices - Martin Fowler, Microservices
https://martinfowler.com/articles/microservices.html - Liu et al., Lost in the Middle: How Language Models Use Long Contexts
https://arxiv.org/abs/2307.03172