前陣子在看 Uncle Bob 的訪問影片,其中有一段提到 SDD 的概念,你可以很明確的發現 Uncle Bob 對這類的做法是高度保留的。而且,SDD 這個概念所倡導的 Spec 才是 Source of Truth,讓過去認為程式碼才是一切的真相的敏捷派擁護者很難接受。
然而,這件事情越想越有趣。
如果你最近十五年,和我們一樣都以敏捷開發為依歸,那你應該早就習慣這句話:
Code is the truth.
這是因為,需求文件可能過期、架構圖可能沒更新、Wiki 上面的說明可能是三年前留下來的,甚至連 User Story 都可能跟現在系統的行為不一樣。
但 Code 不會。
因為機器最後跑的,就是這些 Code,程式碼才是真實的一切。
當每次有人問:「系統現在到底怎麼運作?」最可靠的方法通常不是翻規格書,而是打開 Source Code。
只是,Coding Agent 出現之後,這件事情似乎開始有點動搖了!?
SDD 到底是什麼?
這一年只要你還在軟體開發領域,你一定會常看到這個詞:
Spec-Driven Development,規格驅動開發。
具體的實作有 GitHub Spec Kit、Kiro、OpenSpec 這類工具,雖然方式不完全一樣,但大致上的流程都很接近:
Human Intent
     ↓
   產生 Spec
     ↓
   展開 Plan
     ↓
  展開 Tasks
     ↓
AI Agent(實作)
     ↓
Code / Test / Verify
先把「要做什麼(what)、為什麼要做(why)」講清楚,再談「怎麼做(how)」,接著再拆成 AI Agent 可以執行的工作,最後進入 AI Implementation。
所以 SDD 並不是:
Prompt
 ↓
AI
 ↓
Code
上面這樣就是所謂的 Vibe Coding。
SDD則是:
Human + AI
     ↓
釐清 Intent
     ↓
Living Spec (注意這個 'Living' )
     ↓
Plan / Tasks
     ↓
AI Coding Agent
     ↓
Implementation
這個差異看起來只是中間多了幾份 Markdown。
但其實差很多。
因為 Spec 不再只是開發前拿來參考的文件,而是開始變成後面整個開發流程的輸入。
換句話說:
Spec 不只是 Documentation,而開始變成 Development Input。
這也是為什麼 GitHub 在介紹 SDD 時,會特別強調 specification 開始變得「executable」。
當然,這裡的 executable 不是說你把 spec.md 丟給 .NET SDK 就可以直接 dotnet build。
至少現在還不行。
它真正的意思是:這份 Spec 已經可以被 AI Agent 消費(Consume),再往下產生 Design、Tasks、Code、Test,甚至進一步檢查實作結果到底有沒有符合原本的 Intent。
But,wait a moment,這不就是三十年前的瀑布式開發嗎?
我第一次看到這個概念的時候,腦袋也立刻出現這樣的疑問。
這不就是 Waterfall 嗎?
以前做瀑布式開發,不就是:
需求分析
  ↓
規格書
  ↓
系統設計
  ↓
開發
  ↓
測試
  ↓
交付
而且那個年代的規格書還不是普通地厚。
Business Requirement、Functional Spec、System Design、Database Design……一整套寫完,可能已經過了好幾個月。
然後再把這些文件交給另外一批開發人員照著施工。
從這個角度看,Waterfall 不是就是 Specification-Driven Development。
所以 SDD 是什麼新的軟體工程革命嗎?
顯然不是。還是老外日子過太好,敏捷多年,已經壓根忘記了傳統依照規格書來開發的年代。
(不幸的是,在我們寶島大部分團隊還是瀑布式開發啊)
加上敏捷宣言的起草人 Uncle Bob 都語帶保留,到底, SDD 是怎麼回事?
過去最大的問題,不是規格沒用,而是規格太貴
為什麼大家後來逐漸不喜歡規格文件?
不是因為規格文件不重要,而是因為很貴。
一個 System Analyst 花兩個星期寫規格,交給 Architect 做 Design,再交給 Developer 實作。
完成,完美。
但,需求一改,問題就來。
Requirement
   ↓
Functional Spec
   ↓
Design Document
   ↓
Test Case
   ↓
Source Code
其中只要有一層沒有跟著更新,文件和系統就開始分道揚鑣。
然後過幾個 Sprint 之後,大家就會發現一件事情:
還是看 Code 比較準。文件...太久沒更新了。
於是文件慢慢失去信用。
這也是為什麼 Agile 在 2001 年提出:
Working software over comprehensive documentation
注意,它不是說不要 Documentation。
Agile Manifesto 後面其實還有一句很重要的話:右邊的項目有價值,只是我們更重視左邊。
因此,這二十幾年走下來,很多團隊開始很自然地把需求拆得更小,規格寫得更輕。
於是我們從大型規格書,慢慢一路走成:
User Story
   +
Acceptance Criteria
   ↓
Sprint
   ↓
Working Software
Agile 並沒有消滅 Specification 的企圖心。
它只是讓 Specification:
拆小、延後、持續調整。
AI 出現之後,規格的成本結構變了
這才是現在最值得注意的地方。
以前:
Human
  ↓
花很多時間
  ↓
Specification
  ↓
Human Developer
  ↓
花很多時間
  ↓
Code
訪談需求,寫出規格,很貴。
把規格翻譯成 Code,也很貴。
但現在變成:
Human Intent
     ↓
Human + AI
     ↓
Specification
     ↓
AI Agent
     ↓
Code / Test
AI 同時(注意這個字)降低了兩段(開發、分析)成本:
Intent → Spec
以及:
Spec → Implementation
以前花三天整理的 Spec,現在 AI 可能先在幾分鐘內生出一份 80 分的草稿,然後由人去補那些真正重要的 Domain Knowledge、Business Rule、Edge Case 與 Constraint。
以前 Developer 還得花幾天把 Spec 轉換成 Code。
現在 Coding Agent 也可以瞬間搞定。
這時候,Spec 的 ROI 突然就完全不一樣了。
所以,從AI時代看 SDD 的角度是:
    Waterfall
       Specification First
           │
           │
           ▼
Agile ── Modern SDD ── AI
  │          │          │
  │          │          │
      (小批次)   Living Spec   Automation
             (迭代)          │
                             ▼
                         AI-driven SDLC
它不是回到 Waterfall。
而是把:
過去 Waterfall 中的「規格先行」
加上:
Agile 中的「小批次迭代」
再加上:
AI 的「低成本產生與執行」
三者重新組合在一起。
這三個東西,少一個都不是現在的(理想的) SDD。
Waterfall 的 Spec 與 SDD 的 Spec,最大的差別是什麼?
我覺得最大的差別不是格式。
而是心態。
傳統 Waterfall 的 Spec 比較像:
SPEC v1.0
   ↓
Baseline
(Freeze)
   ↓
Design
   ↓
Development
需求如果變動,通常代表 Change Request。
但 SDD 理想中的 Spec 是:
Spec
 ↓
Plan
 ↓
Code
 ↓
Feedback
 ↓
Update Spec
 ↓
再產生 / 再調整
所以它應該要是(should be) Living(注意這個字) Spec。
Spec 不是一開始寫完就封印起來。
而是系統一路開發下去,它也一路跟著活著。
一個 Feature 可以是一份 Spec。
下一個 Sprint 又有新的 Spec。
每當有新的需求或是舊的功能需要改變,也不是跑去偷偷(直接)修改某一個 if 或某一行程式,而是先回到 Spec 修改 Intent,再讓後面的 Plan、Tasks、Code 與 Test 跟著改,最後再重新產生(或異動)程式碼。
這才是 SDD 跟 Waterfall 真正不一樣的地方。
如果 Spec 是 Source of Truth,那 Developer 到底應該維護什麼?
但討論到這裡,就開始有趣了。
以前我們遇到需求變更,通常是:
Change Request
      ↓
Developer
      ↓
找到那一段 Code
      ↓
修改
      ↓
Commit
但是如果 Spec 才真的是 Source of Truth,比較合理的流程應該變成:
Change Intent
      ↓
Update Spec
      ↓
Update Plan / Tasks
      ↓
AI Agent
      ↓
Update Code + Test
      ↓
Verify
假設原本請假系統的規則是:
超過三天需要二級主管核准。
當公司把規則改成超過五天。
以前 Developer 可能直接去找:
if (leave.Days > 3)
{
    RequireSecondLevelApproval();
}
然後把 3 改成 5。
但如果你真的相信 Spec 是 Source of Truth,那麼真正應該先去改的,是文件中的這一句 Business Rule。
WHEN leave days > 5
THE SYSTEM SHALL require second-level approval
接下來才讓 Implementation 跟著改(這部分AI自行完成)。
所以這裡其實出現了一個很重要的轉換:
需求改變時,我們真正要修改的,是 Intent,而不只是 Code。
那 Code 就不是真相了嗎?
這裡要小心。
我不覺得現在我們可以直接說:「Code 已經不是真相了。」
Code ,它還是真相。它是 Implementation Truth。
Production 跑出來的行為也是真相。
因為它才是最後真正被使用者感受到的 Observed Truth。
因此,比較精確的說法是,未來將同時存在三種 Truth:
Intent Truth
「我們希望系統做什麼?」
        ↓
      SPEC


Implementation Truth
「現在到底怎麼實作?」
        ↓
      CODE


Runtime Truth
「系統實際做了什麼?」
        ↓
  RUNNING SYSTEM
而 SDD 想做的事情,是讓 Spec 成為:
Intent 的 Source of Truth。
並且是 Implementation Truth 的來源,因此,當 Intent 改變時,你應該先去維護這一層。
而這個「先改哪一層」,非常關鍵。
因為誰是 Source of Truth,不是看誰最接近執行結果。
而是看:> 當系統要改變的時候,人類首先維護哪一層?
這讓我想到 Compiler
我們現在寫 C#:
var total = price * quantity;Compile 之後變成 IL,再由 Runtime / JIT 轉成更底層的機器指令。
大概像:
Human
  ↓
 C#
  ↓
Compiler
  ↓
 IL
  ↓
 JIT
  ↓
Machine Code
你會直接去維護 IL 嗎? 正常情況下不會。
不是因為 IL 不重要。(事實上 IL 才是真正的 Truth)
而是因為我們已經有一個更高階、更適合人類表達 Intent,而且可以穩定轉換到下一層的 Representation。
所以我們維護 C# Code。
IL 則轉變成 Intermediate Representation。
那如果有一天,AI Coding Agent 的可靠性再繼續往前走,會不會變成:
Human + AI
     ↓
 Executable Spec
     ↓
 AI Compiler
     ↓
 Source Code
     ↓
 Compiler
     ↓
 Binary
這時候 Source Code 的角色會不會開始變得有點像今天的 IL?
這個問題,就很值得思考了。(尤其是模型發展飛速的今天)
更極端一點:我為什麼還要產生 Source Code?
如果我們繼續往前推。
假設有一天,底下可以實現:
Spec
 ↓
AI
 ↓
Binary
那中間為什麼一定要有 Source Code?
如果同一份 Spec、同一版工具鏈(harness)、同一組 Dependency,在任何環境都可以產生相同的 Artifact(DLL):
spec v3.7
toolchain v12
dependencies.lock
        ↓
      Build
        ↓
SHA256: ABC123...
隔天再 Build 一次:
spec v3.7
toolchain v12
dependencies.lock
        ↓
      Build
        ↓
SHA256: ABC123...
那 Source Code 理論上真的可以只是生成過程中的 Intermediate Artifact。
根本不需要被人看到。
就像我們今天不會每天打開 IL 開發系統一樣(因為我們信任 Compiler)。
當然,現在離這還有一大段距離。
目前的 LLM / Coding Agent 並不是 Compiler。
同一個 Prompt、同一份 Spec,跑兩次肯定會寫出不完全一樣的 Implementation。
單單一個排序,它第一次可能用 Quick Sort,下一次可能換成 Merge Sort。
甚至某一次可能正確、下一次少處理一個 Edge Case。
Compiler 的世界重視:
Determinism、Reproducibility、Traceability、Verification。
而今天的 生成式 AI 根本還沒有完全走到那裡。
所以現在想把 Source Code 丟掉,顯然還太早。
所以 Source of Truth 到底會落在哪裡?
回頭看整個軟體開發史,會發現我們一直在把人類工作的抽象層往上移。
Human
  ↓
Machine Code
Human
  ↓
Assembly
  ↓
Machine Code
Human
  ↓
C# / Java / C++
  ↓
Compiler(IL)
  ↓
Machine Code
Human
  ↓
Prompt / Requirement
  ↓
AI Coding Agent
  ↓
Source Code
Human + AI
     ↓
Living / Executable Spec
     ↓
Verified Build System
     ↓
Artifact
每一次抽象層往上移,都有人擔心下面那一層會不會消失。
但它通常沒有真的消失。
只是逐漸不再是大多數工程師每天直接維護的工作介面。
這也是為什麼我現在看 SDD,覺得它真正有意思的地方,並不是「讓 AI 幫我寫一份規格書」而已。
更值得注意的議題其實是:
未來軟體工程師主要維護的 Artifact,會不會從 Source Code 往上移到 Spec?
如果答案是 Yes。
那我們現在看到的 Coding Agent,可能都還只是過渡期。
真正的終點也許不是:
AI 幫工程師寫更多 Code。
而是:
Code 將不再是工程師需要關注的核心抽象層。
最後
我想用這句話總結 "目前的 SDD"。
其實...SDD 是古老的軟體工程思想,在 AI 時代重新變得經濟可行。
以前我們不是不知道 Spec 很重要。
而是寫 Spec 很貴、維護 Spec 很貴、把 Spec 翻成 Code 更貴。
所以敏捷時代把規格拆小、變輕、並且讓溝通變多,用快速迭代降低預測錯誤的成本。
如今 AI 又把另一塊拼圖補了回來。
我們開始有能力,用比較低的成本,把人類 Intent 整理成 Living Spec,再讓 AI Agent 去使用(Consume)這些 Spec,產生 Design、Tasks、Code、Test,最後再回頭驗證 Implementation 是否真的符合原本的 Intent。
所以它既不是回到 Waterfall,也不是放棄 Agile。
反而比較像:
Waterfall
「規格先行」
      +
Agile
「小批次迭代」
      +
AI
「低成本產生與執行」
      ↓
Modern SDD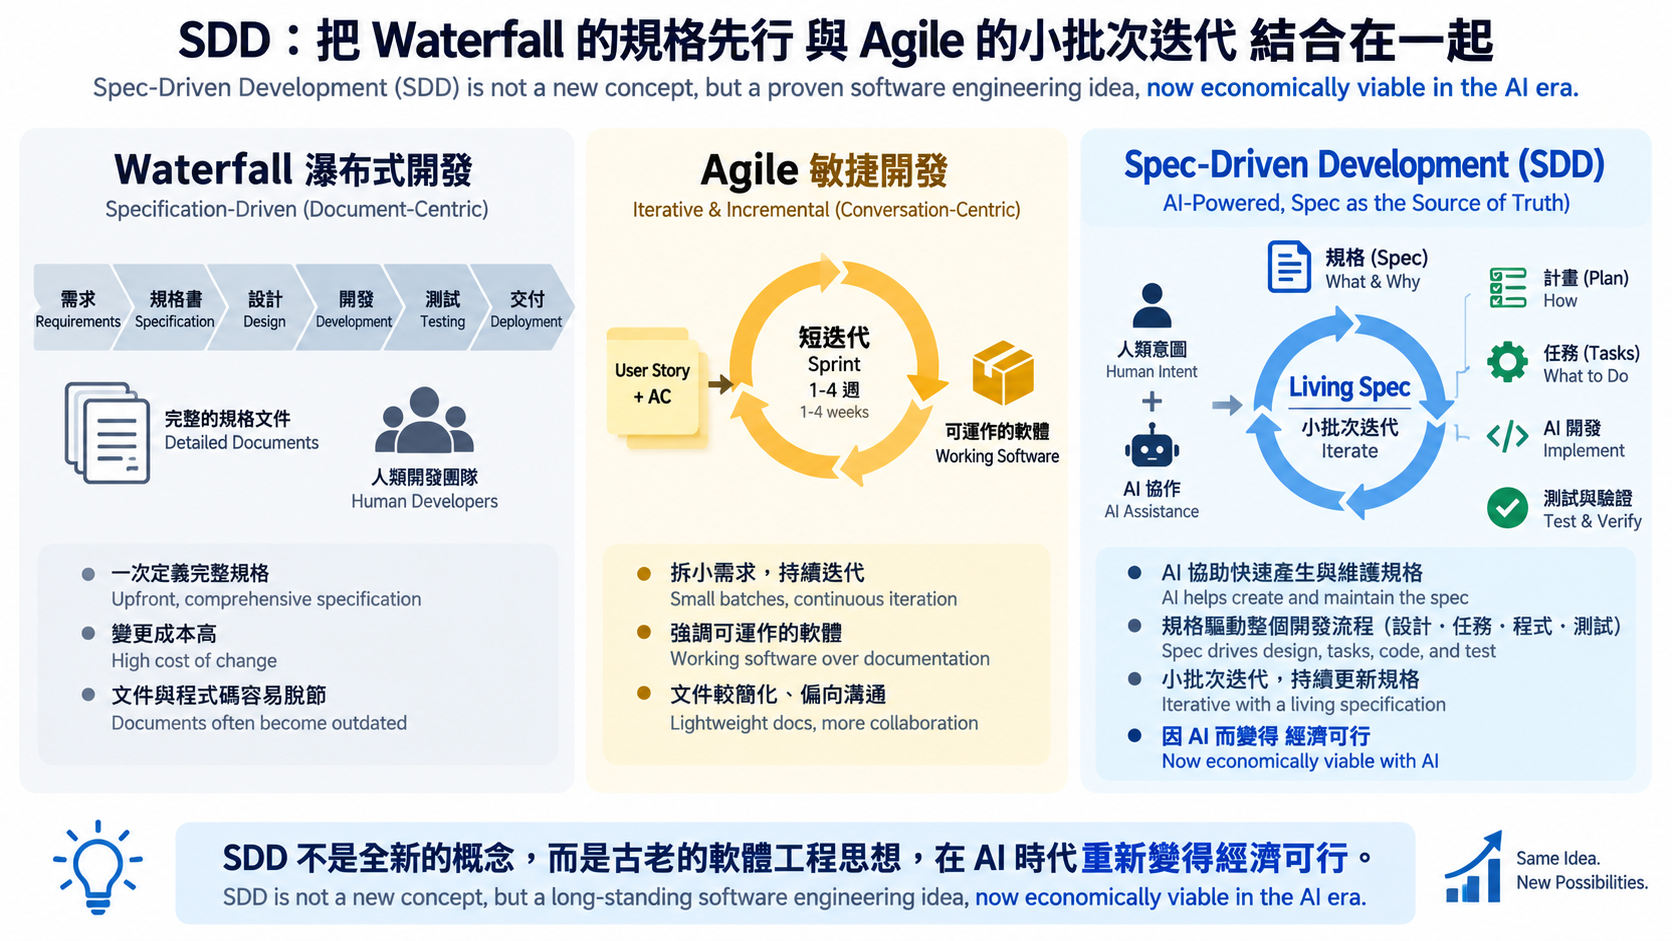
回頭看,傳統 SDD 的企圖心一直都在——希望 Spec 是開發的唯一藍圖。但現實是,程式碼一動,文件就過期,最後還是 Code 說了算。
真正讓這件事開始變得可行的,是現代軟體工程裡那些「可執行的規格」:OpenAPI 的 YAML 既是文件也是程式碼的起點、BDD 的 Given-When-Then 既是規格也是測試、Structurizr 用程式碼畫架構圖——這些東西的共同點是,Spec 不再是靜態文件,而是結構化、可機讀、能自動衍生出程式碼或測試的活文件。
然後 AI 來了。
AI 把這件事推到了一個全新的層次。現在的工具——GitHub Spec-Kit、Remy、Cursor 的 Plan Mode——它們的宣稱更激進:Spec 就是 Source of Truth,程式碼只是 Spec 的副產品。
但這件事在實務上,其實分成三個層級——這個分類來自 ThoughtWorks 工程師 Birgitta Böckeler 在 martinfowler.com 提出的三層分類法:
| 層級 | 模式 | 運作方式 | 成熟度 |
|---|---|---|---|
| Level 1 | Spec-First (規格先行) |
先寫完整 Spec,再整包丟給 AI 生成程式碼 | 已實現。對新專案有效,但後續維護時文件與程式碼容易脫節 |
| Level 2 | Spec-Anchored (規格錨定) |
Spec 跟程式碼一起進 Git,每次改需求先改 Spec,AI 再改程式碼 | 目前最務實的主流做法 |
| Level 3 | Spec-as-Source (規格即原始碼) |
人類只維護 Spec,程式碼變成暫存檔,每次部署從 Spec 重新生成整個系統 | 終極願景,但 LLM 的非確定性讓這件事非常危險 |
這三個層級,跟我前面畫的那五張流程圖——從「最早」到「可能的未來」——幾乎是同一條演化路徑。
我們現在大概在 Level 1 到 Level 2 之間。有些團隊已經把 Spec 放進 Git、讓 AI 照著改程式碼;但離「人類完全不看程式碼」的 Level 3,還有一大段距離。
而 Level 3 最大的障礙,其實就是一個很根本的問題:
同一份 Spec 餵進去,LLM 兩次生成的底層程式碼結構可能不同。這在大型商業系統中非常危險。
Spec 要成為真正的 Source of Truth,光靠「AI 能讀懂」是不夠的。
它必須是可驗證的、可重現的、確定性的。
而這件事,目前還沒有人真正解決。
然而,如果真有一天,Spec 真的能穩定、可重現、可驗證地產生最終 Artifact……
那時候,
Source Code 還會是 Source of Truth 嗎?
還是我們今天視為「文件」的 Spec,才會變成下一個時代真正的 Programming Language?
我不知道。
但這場 Source of Truth 爭奪戰,才剛剛開始。
這場爭奪戰,才剛剛開始。
參考資料
- GitHub Spec Kit — What is Spec-Driven Development? — https://github.github.com/spec-kit/concepts/sdd.html
- GitHub Spec Kit — Quick Start / Spec → Plan → Tasks → Implement — https://github.github.com/spec-kit/quickstart.html
- GitHub Spec Kit — Evolving Specs / Living Spec — https://github.github.com/spec-kit/guides/evolving-specs.html
- Kiro — Feature Specs / Requirements → Design → Tasks — https://kiro.dev/docs/specs/feature-specs/
- OpenSpec — Spec-Driven workflow — https://openspec.dev/docs/schemas/spec-driven
- Manifesto for Agile Software Development — https://agilemanifesto.org/
- Birgitta Böckeler (ThoughtWorks) — Exploring Gen AI: Spec-driven development — https://martinfowler.com/articles/exploring-gen-ai/sdd-3-tools.html